A equipe lançou uma correção na segunda-feira e, duas semanas depois, a ativação subiu 2 pontos. O painel fica verde, e a reunião vira comemoração. Só que, nessas duas semanas, também houve uma campanha, e mais contas grandes se cadastraram. A correção funcionou? Ninguém consegue dizer.
Comparar o antes e o depois é a forma mais comum de avaliar uma mudança, e uma das menos confiáveis, porque muita coisa muda ao mesmo tempo. O teste de hipótese organiza a pergunta para que o resultado diga algo sobre a causa.
O que é um teste de hipótese
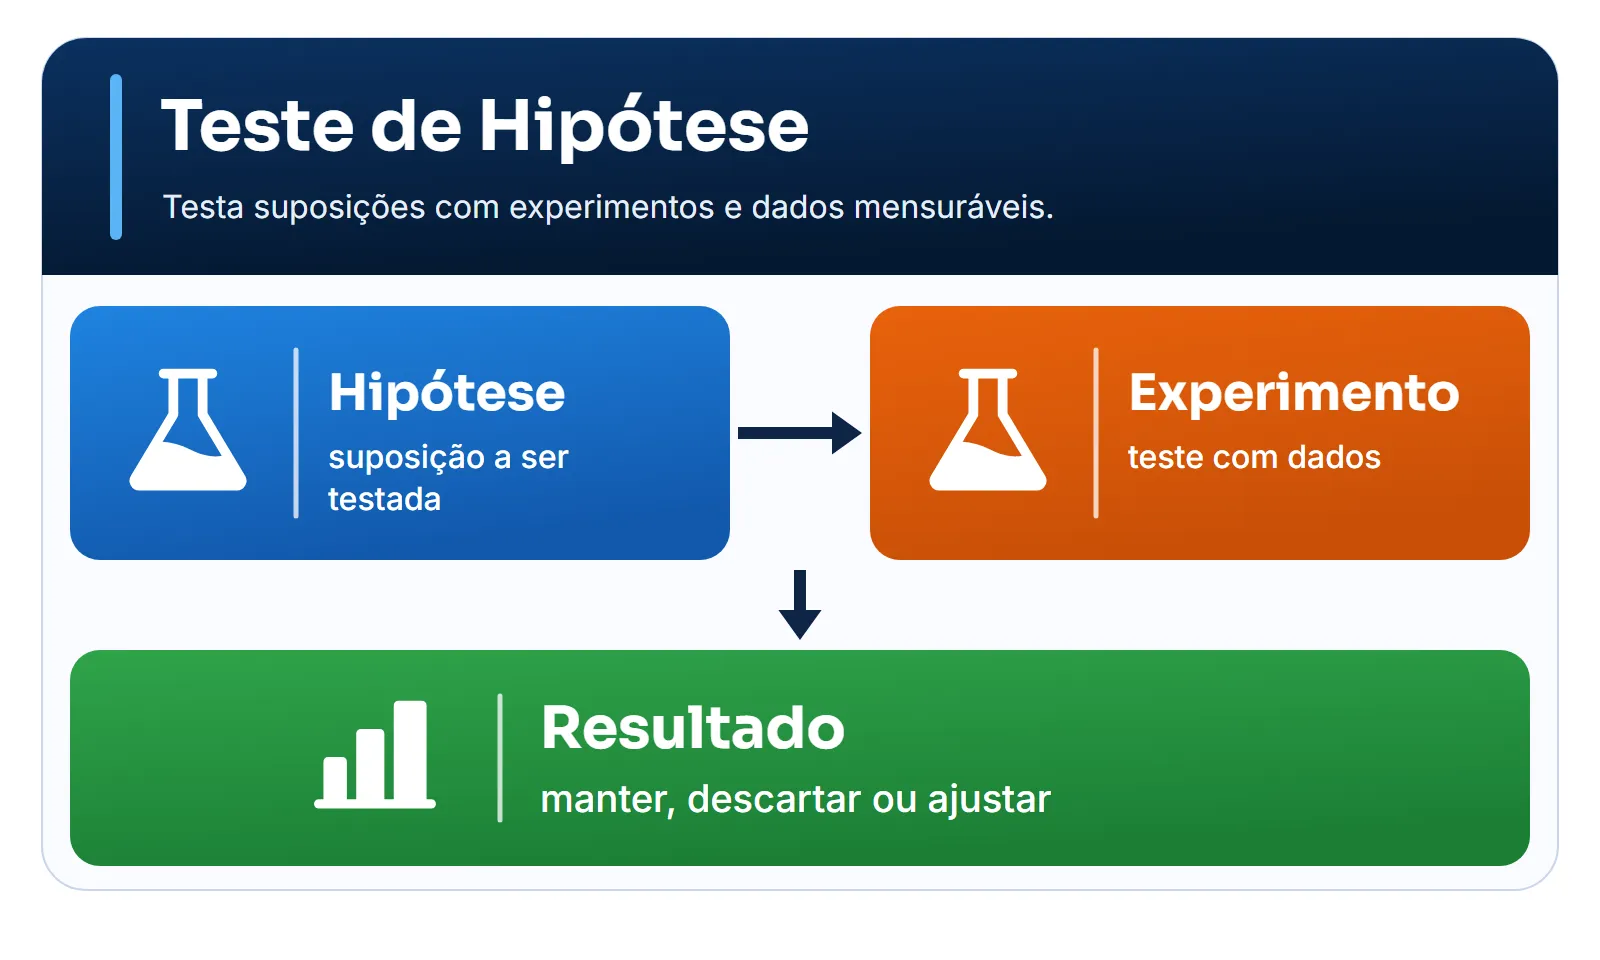
Um teste de hipótese transforma uma suposição sobre causa, comportamento ou resultado em uma afirmação que os dados podem contradizer. A expressão junta duas coisas diferentes:
- A hipótese de produto: uma ideia sobre o que vai acontecer e por quê.
- O teste estatístico: um procedimento para avaliar se a diferença observada é compatível com o acaso. Vem dos trabalhos de Ronald Fisher e de Jerzy Neyman e Egon Pearson, no início do século XX.
Em produtos digitais, a forma mais conhecida é o teste A/B, ou experimento controlado: grupos sorteados recebem versões diferentes ao mesmo tempo. O sorteio é o que importa, porque campanhas, sazonalidade e tipos de cliente tendem a se distribuir igualmente entre os grupos (Kohavi, Tang & Xu, 2020).
O que torna uma hipótese testável
Um bom modelo de frase é: se fizermos [mudança], [métrica] vai [direção e tamanho] para [público] em [prazo], porque [mecanismo]. O mecanismo importa: é ele que mostra o que aprender se o resultado vier diferente.
| Vaga | Testável |
|---|---|
| O assistente vai melhorar | A ativação em 7 dias sobe 4 pontos |
| Os usuários vão gostar | A retenção em 30 dias não cai |
| Deve dar mais conversão | O cadastro sobe de 10% para 12,5% |
25% de quê?
“Uma oferta freemium aumentará o cadastro em 25%” parece claro, mas tem duas leituras. Partindo de 10%:
- 25% relativos: de 10% para 12,5%, um ganho de 2,5 pontos percentuais.
- 25 pontos percentuais: de 10% para 35%.
A diferença não é só de vocabulário. Com os parâmetros usuais explicados adiante, detectar a primeira exige cerca de 2.504 pessoas por grupo. A segunda, cerca de 40.
Quando usar e quando evitar
Quando usar
- Mudanças de produto, UX e conversão com tráfego suficiente
- Avaliar recursos de IA em uso real
- Melhorias de operação com grupos comparáveis
- Quando a decisão é cara e a dúvida é real
Quando evitar
- Volume insuficiente para detectar um efeito relevante
- Correções obrigatórias de segurança ou de lei
- Quando grupos se afetam, como em um mercado com oferta compartilhada
- Quando a decisão já foi tomada, seja qual for o resultado
Como aplicar
- Escreva a hipótese. Inclua mudança, métrica, público, prazo e mecanismo.
- Defina a métrica principal e a unidade. Escolha uma métrica para decidir e diga o que é sorteado: usuário, conta ou loja.
- Defina os guardrails. São as métricas que não podem piorar, como retenção, custo e segurança.
- Calcule a amostra. Escolha o menor efeito que justifica a mudança e calcule quantos casos são necessários.
- Registre a regra de decisão. Escreva antes o que levará a lançar, reverter ou repetir.
- Rode até o fim. Não encerre o teste porque o resultado parece bom. Confira se a divisão dos grupos saiu como planejado.
- Leia e decida. Olhe o efeito e seu intervalo, os guardrails e a regra registrada.
A métrica principal é a decisão mais importante do passo 2. Ela precisa estar ligada ao valor para o cliente, reagir dentro do prazo do teste e ser difícil de inflar. Cliques em um botão reagem rápido, mas sobem até com uma interface confusa. Receita anual é o que interessa, mas demora demais para responder. Uma boa métrica fica no meio do caminho. Kohavi, Tang e Xu falam em um critério geral de avaliação: a métrica, ou combinação de métricas, que resume o objetivo do experimento. Use uma só para decidir, e deixe as demais para explicar o resultado.
Exemplo resolvido: recuperar a ativação
Após o lançamento de um assistente de IA, a ativação de um SaaS caiu de 40% para 30%. Uma conta ativada é a que salva ou compartilha o primeiro resultado em até 7 dias. A investigação apontou duas causas prováveis: o índice dos dados era criado na primeira solicitação, o que tornava a primeira geração lenta, e o assistente abria vazio, sem sugestões.
São boas hipóteses, mas ainda são hipóteses. A hipótese de trabalho: se indexarmos os dados logo após a conexão e devolvermos as sugestões, a ativação em 7 dias das contas novas subirá ao menos 4 pontos, porque menos contas vão abandonar a primeira geração.
| Item | Definição |
|---|---|
| Unidade | Conta |
| Público | Contas novas |
| Divisão | 50/50, sorteio no cadastro |
| Métrica principal | Ativação em 7 dias |
| Taxa atual | 30% |
| Efeito mínimo | +4 pontos |
A unidade é a conta, porque usuários da mesma conta compartilham dados e não poderiam ver versões diferentes. Testar as duas correções juntas também é uma escolha: o teste responde se o pacote funciona, não qual das partes.
Em linguagem estatística, a hipótese nula (H0) diz que as taxas dos dois grupos são iguais, e a alternativa (H1) diz que são diferentes. O teste não tenta provar H1. Ele avalia o quanto os dados seriam surpreendentes se H0 fosse verdadeira.
Guardrails
Uma mudança pode melhorar a métrica principal e prejudicar o negócio. Por isso, a equipe define limites para o que não pode piorar. Kohavi, Tang e Xu separam os guardrails que protegem o negócio dos que protegem a confiança no próprio experimento, como a verificação da divisão dos grupos.
| Guardrail | Limite |
|---|---|
| Retenção em 30 dias | Queda de até 1 ponto |
| Custo de indexação | Até 0,50 real a mais por conta |
| Incidentes de segurança | Nenhum |
Tamanho da amostra
Todo teste convive com dois erros possíveis:
| Decisão | Sem efeito | Com efeito |
|---|---|---|
| Lançar | Falso positivo | Acerto |
| Não lançar | Acerto | Falso negativo |
Significância é o risco aceito de um falso positivo. Poder é a chance de detectar um efeito real, ou seja, de evitar o falso negativo. Para comparar duas proporções, com 5% de significância bicaudal e 80% de poder, a conta aproximada é esta:
- Contas por grupo
- 1,96: para 5% de significância
- 0,84: para 80% de poder
- Soma das variâncias das duas taxas
- Efeito mínimo, em proporção
Com 30% e 34%:
- S = 0,30 × 0,70 + 0,34 × 0,66 = 0,4344
- d = 0,04, então d² = 0,0016
- (1,96 + 0,84)², com os valores completos, dá 7,85
- n = 7,85 × 0,4344 ÷ 0,0016 = 2.131 contas por grupo
Como d aparece ao quadrado, o efeito mínimo domina a conta. Com 600 contas novas por semana, nos dois grupos somados:
| Efeito | Por grupo | Semanas |
|---|---|---|
| 2 pontos | 8.391 | 28 |
| 4 pontos | 2.131 | 7,1 |
| 6 pontos | 961 | 3,2 |
| 10 pontos | 354 | 1,2 |
A escolha do efeito mínimo é de negócio, não de estatística. A equipe fica com 4 pontos, porque menos do que isso não pagaria o custo de manter a indexação. O teste roda por oito semanas completas, para cobrir os ciclos semanais, e cada conta recebe mais 7 dias para amadurecer.
Regra de decisão, registrada antes: lançar se o intervalo de 95% da diferença ficar inteiro acima de zero e nenhum guardrail romper. Se o intervalo incluir zero, o resultado é inconclusivo.
Resultado
Cada grupo teve 2.400 contas:
| Grupo | Ativadas | Taxa |
|---|---|---|
| Controle | 724 | 30,2% |
| Tratamento | 828 | 34,5% |
A diferença é de 4,3 pontos percentuais, ou 14,4% em termos relativos. O intervalo de 95% vai de 1,7 a 7,0 pontos, com z = 3,21 e valor-p = 0,0013.
Na ordem certa, a leitura é:
- A divisão saiu como planejado. Essa é a primeira verificação. Com 4.800 contas, uma divisão de 2.520 e 2.280 teria menos de 0,1% de chance de ocorrer por acaso e indicaria um problema no sorteio. Nesse caso, nenhum outro número mereceria confiança até a causa aparecer.
- O valor-p é baixo. Se não houvesse efeito, uma diferença assim ou maior apareceria em cerca de 1 a cada 750 experimentos. Isso não significa 99,9% de chance de a correção funcionar.
- O intervalo importa mais. Os dados são compatíveis com ganhos de 1,7 a 7,0 pontos. Há sinal de efeito, mas seu tamanho é incerto, e parte do intervalo fica abaixo dos 4 pontos desejados.
- Os guardrails passaram, com uma ressalva. O custo subiu 0,38 real, e não houve incidentes. A retenção em 30 dias foi de 61,8% para 61,5%, mas o intervalo dessa diferença vai de −3,1 a +2,5 pontos. O teste não tem amostra para garantir o limite de 1 ponto, então a retenção segue sendo monitorada depois do lançamento.
A equipe lança a correção. Ela recupera cerca de 4 dos 10 pontos perdidos, e o teste também mostra o que ele não resolveu: ainda faltam quase 6 pontos, e o próximo ciclo começa daí.
Como não se enganar com o resultado
Boa parte dos erros em experimentos acontece na leitura.
- Espiar e parar cedo. Olhar o resultado toda semana e parar no primeiro “significativo” aumenta os falsos positivos. Em uma simulação feita para este artigo, com 300 mil testes sem nenhum efeito real, olhar só no fim deu 4,9% de falsos positivos. Olhar a cada uma das 8 semanas deu 17,6%. Se a equipe precisa acompanhar o teste, existem métodos próprios para isso (Johari et al., 2017).
- Testar muitas coisas. Com 10 comparações independentes a 5%, a chance de ao menos um falso positivo é de 40%. Com 20, é de 64%. Um segmento que “ganhou” deve virar uma nova hipótese, não uma conclusão.
- Ler “não significativo” como “não funciona”. Efeitos grandes podem passar despercebidos em amostras pequenas (Greenland et al., 2016).
- Ler “significativo” como “importante”. Com amostra grande, um efeito trivial também fica significativo. O valor-p não mede o tamanho do efeito.
- Tratar o intervalo como certeza. Os 95% descrevem o método ao longo de muitas repetições. Um intervalo específico contém ou não o valor real.
- Mudar a régua depois. Trocar a métrica principal depois de ver os dados invalida a regra de decisão.
- Acreditar demais no número surpreendente. Um resultado grande demais, ou bom demais, costuma ser sinal de erro de instrumentação. Antes de comemorar, confira os dados.
A declaração da American Statistical Association sobre valor-p resume bem o espírito: ele não mede a probabilidade de a hipótese ser verdadeira, decisões não devem depender só de um limiar, e uma inferência adequada exige transparência sobre o que foi analisado (Wasserstein & Lazar, 2016).
Quando não dá para fazer um teste A/B
Muitos produtos B2B têm poucas contas. Na tabela acima, com 600 contas por semana, detectar 2 pontos levaria mais de meio ano, e com menos tráfego o teste se torna inviável. Nesses casos, a equipe pode buscar um efeito maior, testar uma métrica mais próxima da mudança, liberar por etapas, comparando grupos que recebem a mudança em momentos diferentes, ou usar pesquisa qualitativa. São evidências mais fracas, e isso deve ser dito na decisão.
Como usar uma LLM
Uma LLM ajuda a transformar uma ideia em protocolo: redige a hipótese, sugere guardrails e aponta vieses. Ela pode acertar a forma e errar a conta, então recalcule tudo em uma ferramenta confiável. E vale lembrar: a IA ajuda no desenho, mas não produz evidência ao redigir uma hipótese. Evidência vem do experimento.
Atue como especialista em experimentação de produto.Hipótese de negócio: [afirmação].Métrica atual e baseline: [dados].Mudança proposta: [intervenção].Público, unidade experimental e restrições: [informar].
Converta a ideia em hipótese mensurável, incluindo H0/H1 quando fizersentido. Defina métrica principal, guardrails, critérios de sucesso,segmentos, riscos de viés e desenho experimental (A/B ou alternativa).Explique quais informações são necessárias para estimar tamanho deamostra e duração. Não declare significância, poder estatístico ouganho causal sem dados suficientes.
Saída esperada: protocolo de experimento e plano de análise.
Antes de confiar na resposta:
- Refaça a conta de amostra. Use uma calculadora ou um script, e confira se o efeito é relativo ou em pontos.
- Confira a unidade. Pergunte se a unidade sorteada é a mesma da métrica.
- Peça o que invalidaria o teste. O modelo deve apontar interferências entre grupos, sazonalidade e falhas no sorteio.
- Sanitize o contexto. Não envie dados individuais de clientes nem métricas internas identificáveis.
Combine com outros frameworks
- Princípio MECE: define as etapas e as métricas sem sobreposição.
- Diagrama de Ishikawa: gera as hipóteses sobre as causas.
- 5 Porquês: aprofunda uma causa antes de testar a correção.
- Matriz de decisão: escolhe qual intervenção vale testar.
- Ciclo OODA: usa o resultado para orientar o próximo ciclo.
Referências
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N. & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: a guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. DOI
- Johari, R., Koomen, P., Pekelis, L. & Walsh, D. (2017). Peeking at A/B Tests: Why It Matters, and What to Do About It. KDD ‘17, 1517–1525. DOI
- Kohavi, R., Tang, D. & Xu, Y. (2020). Trustworthy Online Controlled Experiments. Cambridge University Press. DOI
- Wasserstein, R. L. & Lazar, N. A. (2016). The ASA Statement on p-Values: Context, Process, and Purpose. The American Statistician, 70(2), 129–133. DOI