Peça a um LLM: “Corrija o bug, rode os testes e abra um PR”. Sozinho, ele não consegue. Um modelo de linguagem recebe texto e devolve texto. Ele não abre arquivos, não roda testes, não lembra o que fez dez minutos atrás e não sabe o que tem permissão para fazer.
O que transforma esse modelo em um agente capaz de cumprir o pedido é a camada de software em volta dele: o harness. Pense no LLM como o cérebro. O harness é tudo o que permite a esse cérebro agir no mundo real com segurança.
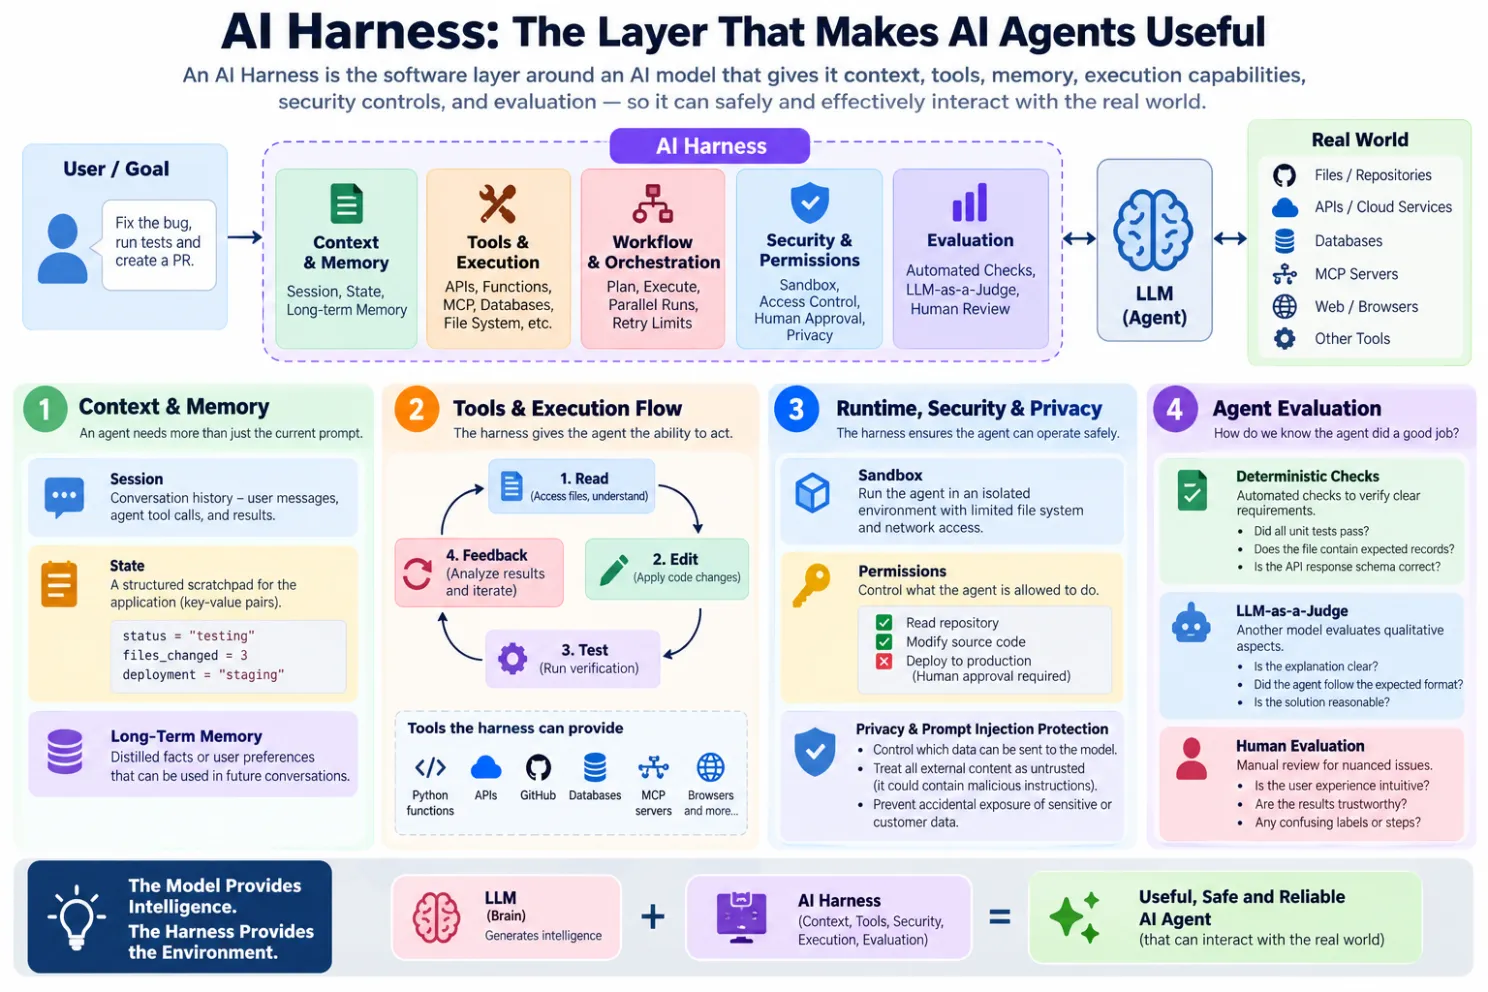
O que é um AI harness
Três termos aparecem juntos e se confundem com frequência:
- LLM: o modelo. Interpreta instruções e gera texto.
- Agente: o LLM usando ferramentas, em várias etapas, para cumprir um objetivo.
- Harness: a estrutura em volta do modelo que torna isso possível e seguro. Ela decide o que entra no contexto, quais ferramentas existem, quando parar, o que exige aprovação e como conferir o resultado.
O harness não é um prompt longo nem um framework específico. Pode ser um script de cem linhas ou uma plataforma inteira. A Anthropic, por exemplo, descreve o SDK que roda o Claude em ciclo como um harness de agente de uso geral (Anthropic, 2025).
Para ver um harness que coordena vários agentes, leia Six Thinking Hats na Era das LLMs.
As cinco peças de um harness
1. Contexto e memória
Um agente precisa de mais do que o pedido atual. O harness organiza três tipos de informação:
| Tipo | O que é |
|---|---|
| Sessão | O que aconteceu. Mensagens, decisões, chamadas de ferramenta e resultados. |
| Estado | O que está acontecendo agora. Os valores da tarefa em andamento. |
| Memória | O que vale lembrar. Fatos e preferências guardados para as próximas conversas. |
O estado funciona como um rascunho estruturado. No pedido do PR, ele poderia ser assim:
status = "testing"files_changed = 3deployment = "staging"Com isso, o agente não precisa reler a conversa inteira para saber em que ponto está.
2. Ferramentas e execução
Um LLM só gera texto. Ele vira agente quando pode agir, e quem entrega as ferramentas é o harness: funções em Python, APIs, bancos de dados, GitHub, navegador, serviços de nuvem e servidores MCP, o protocolo aberto que conecta modelos a ferramentas e fontes de dados.
No pedido do PR, o trabalho vira um ciclo:
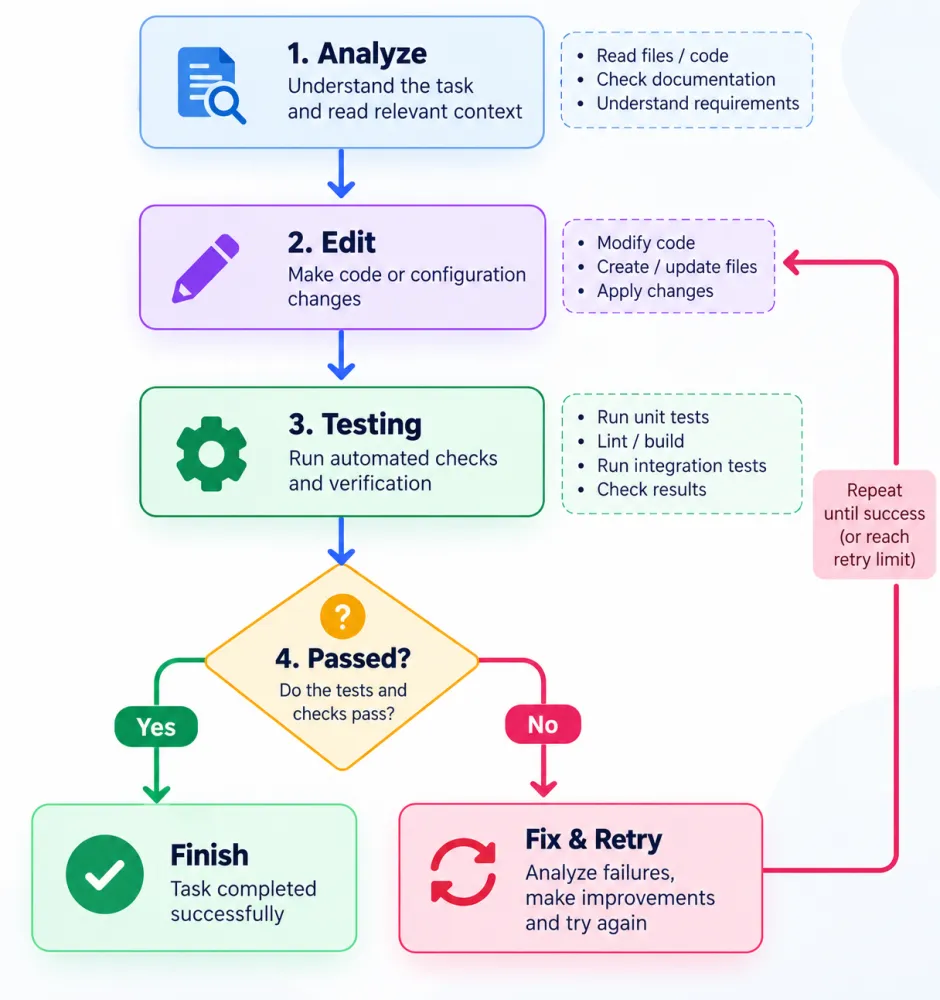
Ler o código, entender, editar, rodar os testes, ler o resultado e corrigir. Conduzir esse ciclo é uma das tarefas mais importantes do harness.
3. Fluxo e limites
Além de executar, o harness decide como o trabalho avança. Ele planeja as etapas, roda uma de cada vez ou várias em paralelo e define quando parar.
4. Segurança, permissões e privacidade
Aqui o harness se torna indispensável, principalmente em empresas. Imagine um agente de código com acesso ao banco de produção, a dados de clientes, aos repositórios, às credenciais de nuvem e às APIs internas. Ninguém quer dar a ele acesso irrestrito a tudo isso. O harness controla três coisas:
- Sandbox: o agente roda em um ambiente isolado, com acesso limitado a arquivos e à rede.
- Permissões: o que o agente pode fazer sozinho e o que precisa de aprovação.
- Privacidade: quais dados podem ser enviados ao modelo.
No pedido do PR, as permissões poderiam ficar assim:
| Ação | Permissão |
|---|---|
| Ler o repositório | Liberada |
| Editar o código | Liberada |
| Abrir o PR | Liberada |
| Deploy em produção | Só com aprovação humana |
5. Avaliação
Um dos maiores desafios com agentes é saber se o trabalho ficou bom. O harness pode combinar três camadas, da mais barata à mais cara:
- Checagens determinísticas, quando a resposta pode ser verificada de forma objetiva. Todos os testes passaram? O arquivo tem os registros esperados? A resposta da API segue o esquema?
- LLM como juiz, para o que é qualitativo. Outro modelo avalia se a descrição do PR está clara e se o agente seguiu o formato pedido.
- Revisão humana, para o que é difícil automatizar. O resultado é confiável? A experiência ficou confusa? Um desenvolvedor aceitaria esse PR?
O LLM como juiz ajuda, mas não substitui as outras camadas. Ele tem vieses conhecidos: tende a preferir a primeira resposta mostrada, as respostas mais longas e os textos do próprio modelo (Zheng et al., 2023). Compare as notas dele com avaliações humanas antes de confiar nelas.
Como as peças se conectam
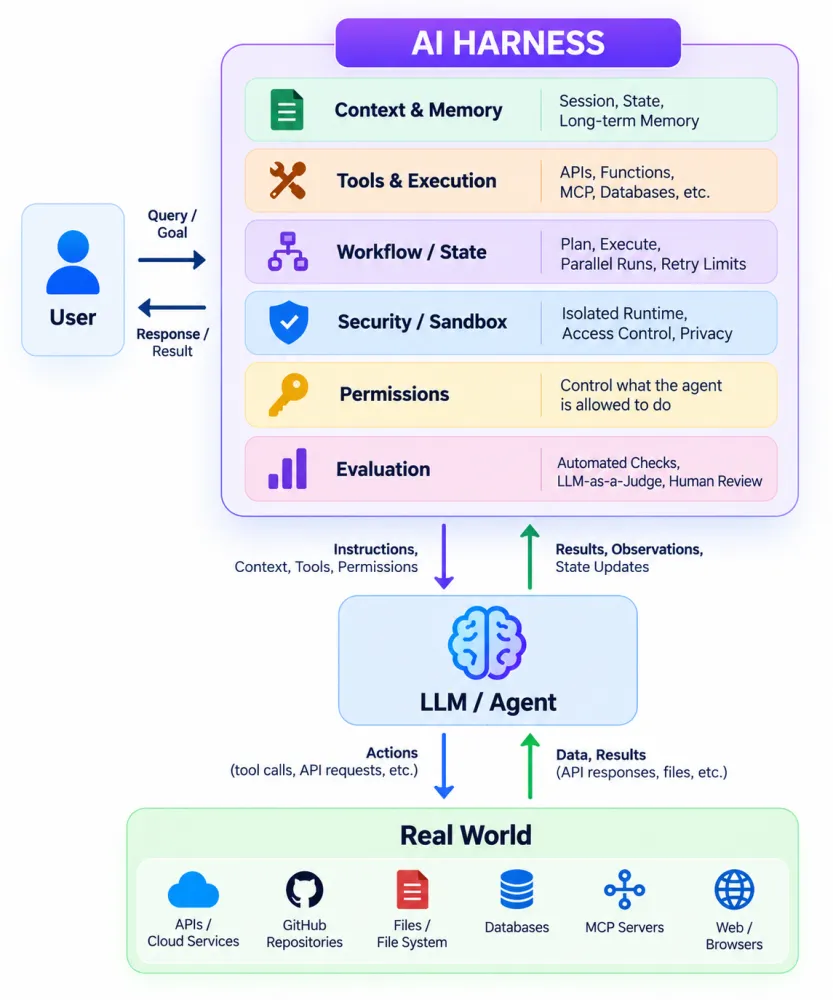
Siga as setas da imagem:
- O usuário entrega o pedido ao harness.
- O harness monta o que o modelo precisa: instruções, contexto, ferramentas disponíveis e permissões.
- O modelo escolhe a próxima ação, como ler um arquivo ou chamar uma API. Na prática, ele só pede a chamada. Quem a executa no mundo real é o harness, depois de conferir as permissões.
- O resultado volta, e o harness atualiza o estado, confere os limites e decide se o ciclo continua.
- Quando a tarefa termina ou um limite é atingido, o harness avalia o resultado e responde ao usuário.
Uma analogia: o funcionário
Pense em uma pessoa recém-contratada. O LLM é a inteligência dela. O harness é o local de trabalho em volta:
| Harness | Na empresa |
|---|---|
| Memória | O que ela já sabe e anotou |
| Ferramentas | Computador, GitHub, bancos e sistemas |
| Permissões | Os acessos que recebeu |
| Sandbox | Um ambiente de testes, onde errar não quebra nada |
| Workflow | Os processos da empresa |
| Avaliação | Code review e QA |
| Aprovação humana | O gestor que libera o que é sensível |
A pessoa pode ser brilhante. Mesmo assim, é o ambiente em volta dela que define com que segurança e eficiência essa inteligência é usada.
Checklist: perguntas para desenhar o seu harness
Um LLM, sozinho, não sabe responder a nenhuma destas perguntas. O harness precisa responder por ele:
- O que o agente pode acessar?
- Quais ferramentas ele pode usar?
- Onde fica o estado da tarefa?
- Quando ele deve tentar de novo?
- Quando ele deve parar?
- Como saber se o resultado está correto?
- Quais ações exigem aprovação humana?
- Que dados nunca podem ser enviados ao modelo?
Conclusão
Os sistemas de IA estão saindo do chat e passando a agir: editam código, consultam bancos, abrem PRs. Nessa mudança, a escolha do modelo continua importante, mas deixa de ser a única decisão. Contexto, ferramentas, memória, fluxo, segurança, permissões e avaliação também são escolhas de engenharia, e são elas que separam uma demonstração de um sistema confiável.
O modelo fornece a inteligência. O harness fornece o ambiente em que essa inteligência trabalha.
Referências
- Anthropic (2024). Building effective agents. Link
- Young, J. / Anthropic (2025). Effective harnesses for long-running agents. Link
- OWASP (2025). LLM01:2025 Prompt Injection. OWASP Top 10 for LLM Applications. Link
- Zheng, L. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks. arXiv:2306.05685